Une langue qui tient dans un disque dur
Le kabyle est une langue berbère, ma langue maternelle. Tout le texte kabyle exploitable représente environ 40 millions de tokens : trois à quatre ordres de grandeur de moins que ce qu'il faut pour entraîner un modèle généraliste. Une partie dort dans quelque 600 PDF publiés par la communauté, souvent composés avec des polices d'avant Unicode.
Même les modèles multilingues le lisent mal. J'ai mesuré combien de tokens il faut en moyenne pour écrire un mot kabyle avec leurs tokenizers, sur 400 000 caractères :
| Tokenizer | tokens par mot |
|---|---|
| Qwen3 (1,7B / 4B) | 2,77 |
| SmolLM3-3B | 2,96 |
| Mistral-7B v0.3 | 3,03 |
| NLLB-200, entraîné avec du kabyle | 2,26 |
Un texte anglais tourne autour de 1,3 token par mot : le kabyle coûte donc environ 2,1 fois plus à Qwen3, en calcul comme en contexte. Contrairement à ce que je pensais, les lettres spéciales (ɣ, ḍ, ɛ) n'y sont presque pour rien (pénalité de 1,06) : c'est la morphologie qui coûte.
02 · Premier essaiUn modèle qui apprend par cœur
Ma première version était un GPT classique de 43,27 M de paramètres (8 couches, contexte de 128 tokens), entraîné sur 2 GPU T4 avec les 995 159 tokens de Wikipédia en kabyle. Le tokenizer découpait sur les tirets et mettait tout en minuscules : 35 000 mots distincts, dont 42 % n'apparaissaient qu'une fois, et 6,5 % de mots inconnus.
Résultat : une perte de 1,33 à l'entraînement et 6,21 en validation. Le modèle n'était pas sous-entraîné, il avait mémorisé son corpus. D'après la loi de Chinchilla, 1 M de tokens justifie un modèle d'environ 50 000 paramètres : le mien était près de 800 fois trop gros.
03 · Les donnéesDéchiffrer avant d'entraîner
La plus grosse partie du travail a été de rendre le texte utilisable. Trois problèmes propres au kabyle :
Des lettres qui ont plusieurs formes. Le ɛ latin, le ε grec et le ԑ cyrillique désignent la même lettre ; ɤ remplace souvent ɣ. Chaque variante crée des mots en double dans le vocabulaire. Le pipeline les normalise au lieu de les rejeter.
Des polices qui chiffrent le texte. Les livres anciens sont composés avec des polices où $ veut dire ɣ et î veut dire ṭ. C'est un chiffrement par substitution, différent pour chaque police, et parfois entre le romain et l'italique d'un même livre. J'ai écrit un décodeur qui travaille police par police, et un solveur qui retrouve automatiquement la table d'une police inconnue en minimisant le taux de mots absents d'un dictionnaire kabyle.
Des mots qui portent une phrase. Le kabyle est agglutinant : yenna-yas (« il lui a dit ») contient sujet, verbe et complément. Le pipeline conserve ces clitiques au lieu de les couper.
Chaque bug rencontré est devenu un test : 40 tests de régression, tous tirés de cas réels.
04 · Le modèlePré-entraîner sur les livres, affiner sur les messages
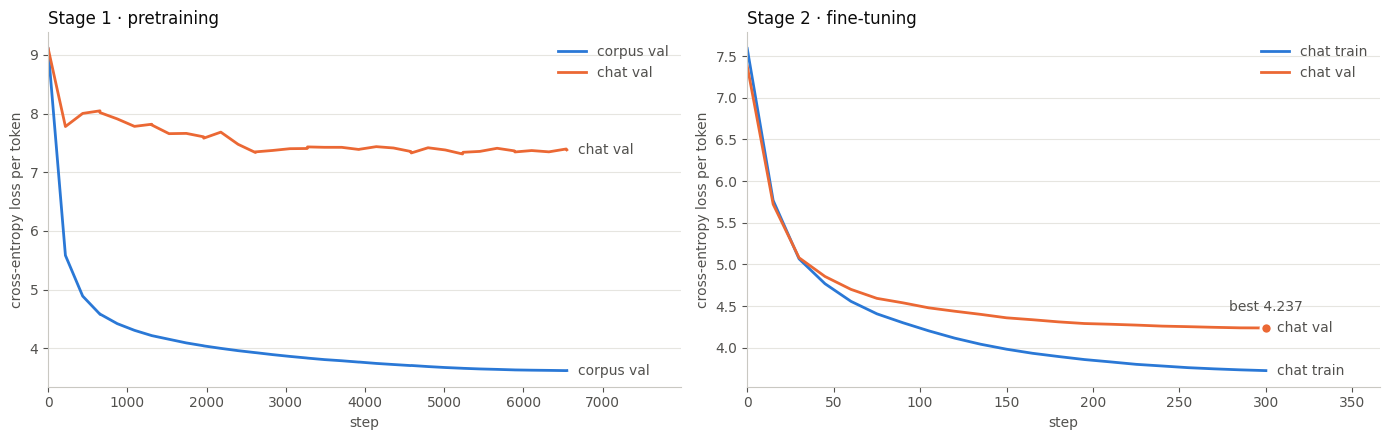
La deuxième version est un Transformer décodeur de type Llama, entraîné de zéro en deux étapes sur une seule T4 de Kaggle.
| Architecture | décodeur seul · RMSNorm · RoPE · SwiGLU (1 408) |
|---|---|
| Taille | 10 couches · dmodel 512 · 8 têtes de 64 · contexte 512 tokens |
| Tokenizer | BPE au niveau de l'octet, 8 192 tokens |
| Paramètres | 36 317 696 |
| Étape 1 | pré-entraînement sur 1,0 M de lignes (120 M de caractères) converties à l'orthographe des messages : 6 548 pas × 16 384 tokens = 107,3 M de tokens, 46 min |
| Étape 2 | fine-tuning sur un corpus de discussion privé : 300 pas, 20 % de corpus rejoué dans chaque lot, 1 min 36 s |
Un gain réel, mais modeste
Pour comparer des modèles aux tokenizers différents, je mesure les bits par caractère sur les mêmes 6 600 messages de validation (plus bas, c'est mieux) :
| Modèle | bits par caractère |
|---|---|
| 11,4 M de paramètres, entraîné sur la discussion seule | 2,046 |
| 36,3 M, pré-entraîné seulement (n'a jamais vu la discussion) | 3,445 |
| 36,3 M, pré-entraîné puis affiné | 1,977 |
Le pré-entraînement seul ne suffit pas : le style des messages est trop loin de celui des livres. Combiné au fine-tuning, il bat le modèle entraîné sur la discussion seule de 3,3 %. C'est une amélioration mesurable, pas une percée.
06 · La suiteAdapter plutôt que tout réapprendre
Avec 40 M de tokens, un modèle entraîné de zéro ne saura jamais raisonner. La voie suivante est d'adapter un modèle multilingue : lui apprendre la langue, et garder ce qu'il sait du monde. Le pipeline est écrit et testé : décodage des PDF, corpus filtré et dédoublonné, extension du vocabulaire (cible autour de 1,9 token par mot), pré-entraînement continu, instruction tuning, évaluation et export GGUF pour tourner sur un ordinateur portable. Le budget est estimé à 28 heures de GPU, environ une semaine de quota Kaggle ; comme une T4 ne gère ni le bf16 ni FlashAttention-2, le code détecte la carte et bascule en fp16 avec l'attention SDPA.
Les corpus viennent en grande partie de la communauté NLP kabyle (Imsidag-community, boffire), de Tatoeba, de Common Voice et de Wikipédia. Rendre à cette communauté un corpus fusionné et normalisé serait sans doute plus utile que le modèle lui-même.