Vingt jours de mesures, 38 capteurs, 9,5 % d'anomalies
Le jeu de données est le Server Machine Dataset publié avec OmniAnomaly (licence MIT) : 38 mesures d'un serveur relevées chaque minute pendant vingt jours, une partie d'entraînement sans incident et une partie de test étiquetée point par point — 28 479 points, dont 9,5 % anormaux répartis en une douzaine d'épisodes.
J'y compare quatre détecteurs : un autoencodeur convolutif (27 094 paramètres, entraîné six secondes sur des fenêtres de 64 minutes, l'erreur de reconstruction servant de score) ; l'écart à la moyenne glissante sur 32 minutes ; l'écart au point précédent ; et un score tiré au hasard, qui ne regarde rien du tout et sert de contrôle.
Le même détecteur, deux notes très différentes
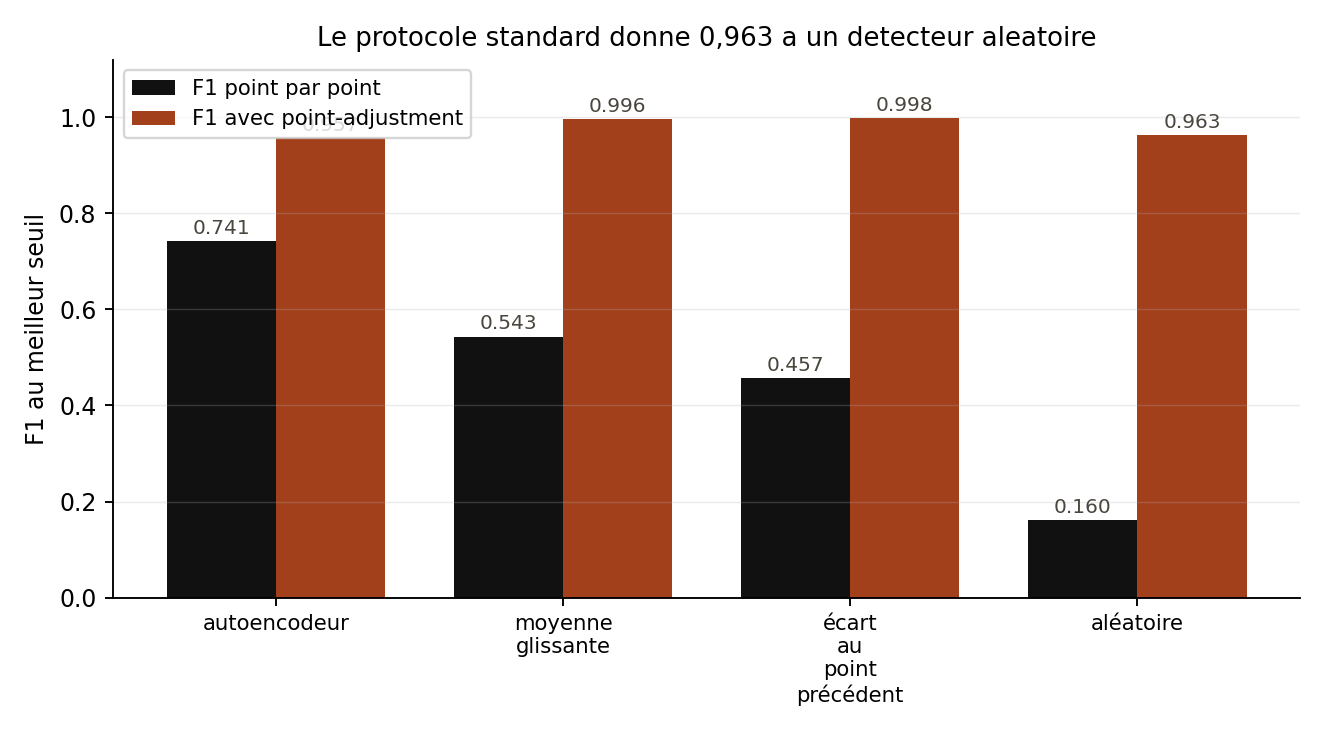
La quasi-totalité des articles du domaine évalue avec le point adjustment : si un seul point d'un épisode anormal est détecté, on considère l'épisode entier comme détecté. L'intention est défendable — repérer une panne à la minute près importe peu. L'effet, lui, est dévastateur : il suffit d'un point au hasard dans un long épisode pour rafler tout le crédit. Kim et ses collègues l'ont montré en 2022 ; je l'ai remesuré ici.
| Méthode | F1 point par point | F1 avec point-adjustment | Aire PR |
|---|---|---|---|
| autoencodeur convolutif | 0,741 | 0,957 | 0,653 |
| écart à la moyenne glissante | 0,543 | 0,996 | 0,531 |
| écart au point précédent | 0,457 | 0,998 | 0,467 |
| score aléatoire | 0,160 | 0,963 | 0,094 |
Avec le protocole standard, les quatre méthodes rendent la même copie : entre 0,957 et 0,998. Le score aléatoire obtient 0,963, soit mieux que l'autoencodeur. Publié tel quel, ce tableau ferait croire à un excellent détecteur.
03 · Ce que la mesure honnête montreLe modèle appris sert — mais pas là où on croyait
Point par point, le classement redevient informatif : l'autoencodeur atteint 0,741 contre 0,543 pour la moyenne glissante, 0,457 pour l'écart au point précédent et 0,160 pour le hasard. L'aire sous la courbe précision-rappel dit la même chose (0,653 contre 0,531, 0,467 et 0,094).
La conclusion n'est donc pas que l'apprentissage ne sert à rien — c'est l'inverse : il apporte près de vingt points de F1 sur la référence la plus sérieuse. Mais le protocole le plus répandu est incapable de le montrer, puisqu'il donne presque la même note à tout le monde. Avant de comparer deux modèles, il faut vérifier que la balance pèse.
04 · Le détecteur du bac à sableCe qu'il fait, et ce qu'il ne fait pas
Le modèle que vous manipulez plus haut n'a vu qu'une seule des 38 mesures, choisie pour être lisible à l'œil (la plus régulière sur vingt-quatre heures). Il réagit à ce qui ne ressemble pas à ce qu'il a appris, ce qui se voit très bien en dessinant. Mais il faut le dire : sur le vrai jeu, ce détecteur à une dimension obtient un F1 de 0,196, à peine au-dessus du hasard (0,160). Une seule mesure ne porte pas les pannes du serveur ; c'est le modèle à 38 dimensions qui les attrape.
Le modèle exécuté dans la page est bien celui qui a été entraîné : l'écart maximal entre le portage JavaScript et PyTorch est de 7·10⁻⁶ sur la reconstruction et de 3·10⁻⁷ sur l'erreur.